Mastering Cyber Security in This Crazy World!
Édition 1 · RWID · Ecobook Edition
Écrit par Eko Suprapto Wibowo, fondateur de Remote Worker Indonesia.
Ce livre est né d’un événement réel : une attaque automatisée contre
remoteworker.id le 2 octobre 2026. Plutôt que de la dissimuler, nous
l’avons rendue publique et nous en sommes servis comme matière pédagogique.
Chaque chapitre suit le même schéma :
théorie → pratique courante dans l’industrie → la façon dont Ecosphere procède → extraits de l’incident réel.
Ce livre n’est pas un résumé d’actualité. Il explique pourquoi un système est construit ainsi, et pas seulement ce qui a été mis en place.
Ce livre grandit. Chaque nouvelle attaque contre RWID deviendra un nouveau chapitre dans l’édition suivante. Acheter ce livre, c’est posséder un recueil qui ne cesse de s’enrichir — et non une lecture unique que l’on referme. Plus il y a de personnes qui tentent de nous faire tomber, plus le livre s’épaissit.
© RWID. Publié en tant qu’Ecobook.
Avant-propos
RWID (Remote Worker Indonesia) existe depuis 2017. En 2025, il est devenu viral — et cette viralité s’est accompagnée d’accusations malveillantes de la part de nombreuses personnes qui ne le connaissaient pas : arnaque (« scam »). J’ai raconté le côté humain de cette histoire sur la page Bienvenue de cette application, et je ne vais pas tout répéter ici. Une seule conséquence mérite que vous la reteniez : RWID s’est arrêté, puis, un an plus tard, a décidé de revenir.
En décidant de revenir, j’ai réordonné les priorités. Pas les fonctionnalités d’abord. Pas l’apparence d’abord. La sécurité d’abord. La raison est simple : cette accusation d’arnaque, fondée ou non, m’a fait comprendre que RWID ne pourrait jamais rien prouver si son système s’effondrait dès la première attaque. En 2025, j’ai construit vite, en m’appuyant sur de nombreux services tiers, et je me suis adapté d’une manière que je juge moi-même indéfendable. L’une de ces décisions a fait disparaître toutes les procédures stockées de RWID. Depuis, je m’en tiens à un principe : Zero Trust — ne faire confiance à rien de ce qui vient d’Internet tant que cela n’a pas prouvé sa légitimité.
Ainsi, quand RWID est revenu en 2026, je l’ai bâti sur des fondations différentes, et j’ai lancé un défi ouvert au monde :
Cette publication — sur Instagram et Threads — a été le déclencheur. Je me suis volontairement exposé. Les attaques qui sont arrivées n’étaient pas une surprise ; c’étaient des invités que nous avions conviés. Le but était unique : prouver publiquement que ce système est solide — et, si ce n’est pas encore le cas, vouloir le savoir maintenant, et non au moment où des millions de personnes regardent.
Ce livre est né de cette invitation. Il explique la théorie de sécurité qui le sous-tend, l’architecture que nous avons construite, et les attaques réelles que nous avons effectivement repoussées quelques heures après la diffusion de cette publication.
Une chose revient sans cesse sous vos yeux : notre force ne réside pas dans une grande muraille unique, mais dans la manière dont nous assemblons le système, de sorte qu’un petit correctif puisse se propager rapidement à l’ensemble. C’est cela, Ecosphere.
— Eko
Comment lire ce livre
Ce livre est écrit pour les bâtisseurs de produits — en particulier ceux qui apprennent en construisant (vibe coders, solo builders, du débutant à l’intermédiaire). Je ne suppose pas que vous maîtrisez déjà la sécurité. Je suppose seulement que vous savez construire une application web et que vous voulez la construire selon des standards de production.
Chaque chapitre suit le même schéma, et c’est ce schéma qui rend ce livre utile :
- Théorie. Le concept de base, et la raison qui le sous-tend. Pas de par cœur.
- Pratique courante dans l’industrie. La manière dont le monde le traite habituellement.
- La façon d’Ecosphere. Comment la plateforme que nous construisons l’applique.
- Extraits de l’incident. Des morceaux de la véritable attaque du 2 octobre 2026 qui illustrent ce point.
Vous pouvez lire dans l’ordre, ou sauter au chapitre dont vous avez besoin. Le
signe → indique une lecture complémentaire. J’ai conservé les termes
techniques anglais lorsqu’ils sont bel et bien la terminologie consacrée
(payload, rate limit, query), afin que vous les reconnaissiez dans n’importe
quelle documentation.
Ce livre ne remplace pas la pratique. À la fin se trouvent les Tools : un bouton pour lancer des simulations d’attaque sur le portail RWID, une liste de contrôle pour le réglage de la sécurité, et un modèle de signalement à l’attention des fournisseurs d’accès à Internet (FAI).
Table des matières
Partie 1 · La scène
- 1 · Un monde vivant
- 2 · Aperçu de l’incident : une IP, dix-huit minutes
- 3 · Qu’est-ce qu’Ecosphere (et pourquoi LXS seul ne suffit pas)
Partie 2 · Pourquoi ce système est solide
- 4 · Racines théoriques : Domain-Driven Design & Bounded Context
- 5 · LXS : Linux Services comme briques de construction
- 6 · Gateway & Auth : la source de force qui corrige vite
Partie 3 · Fondements de la sécurité
- 7 · La sécurité est une propriété du système, pas une fonctionnalité
- 8 · Modèle de menace & surface d’attaque
- 9 · Deny-by-Default, Least Privilege, Defense-in-Depth
Partie 4 · Classes d’attaques & défenses
- 10 · Injection & requêtes paramétrées
- 11 · XSS, échappement et Content Security Policy
- 12 · Sessions & authentification : de localStorage à HttpOnly
- 13 · Gestion des secrets
- 14 · SSRF, Open-Redirect et validation des URL
- 15 · Abus : spam d’inscription, bots et scanners
- 16 · Chaîne d’approvisionnement logicielle
Partie 5 · Opérations & passage à l’échelle
- 17 · La périphérie : WAF, DDoS, et pourquoi l’origine ne sent presque rien
- 18 · Observability & Alerting : le guard qui crie
- 19 · Une réponse aux incidents sereine
- 20 · Préparation à l’échelle & quotas
Partie 6 · Étude de cas & outils
- 21 · Étude de cas : chronologie complète du 2 octobre 2026
- 22 · L’architecture de sécurité d’Ecosphere, de bout en bout
- 23 · Tools : testez votre propre système
Ce livre grandit. Chaque nouvelle attaque contre RWID deviendra un nouveau chapitre dans l’édition suivante. Acheter ce livre, c’est posséder un recueil qui se met continuellement à jour — et non une lecture unique que l’on referme.
1 · Un monde vivant
Avant l’incident, avant la théorie, il y a une chose que vous devez d’abord voir. Voici le visage de RWID :
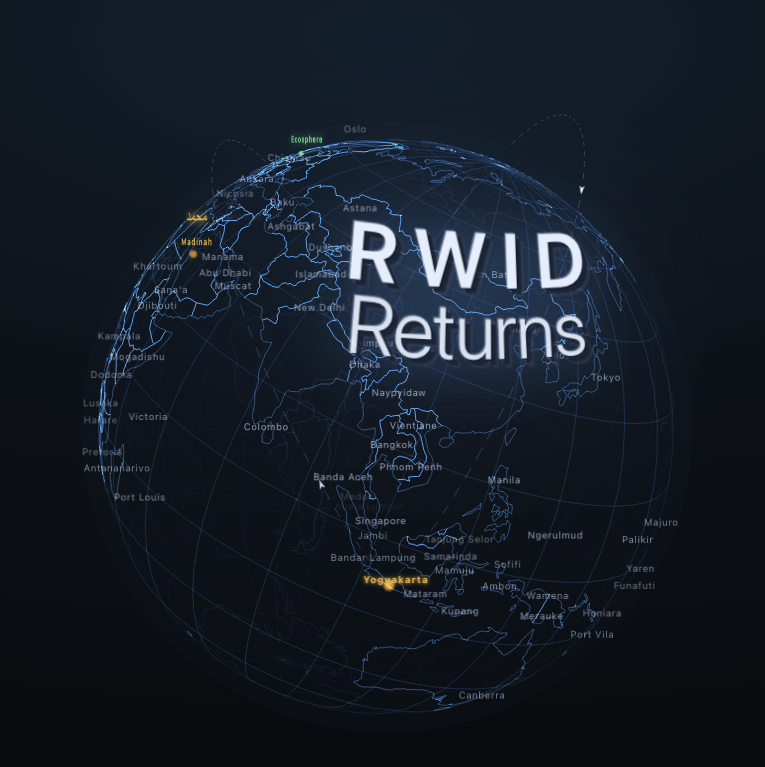
Ce globe n’est pas un ornement. Il n’a pas été conçu à la légère. Il a été pensé comme un moniteur système mondial en temps réel — un écran unique qui répond à la question « que se passe-t-il dans tout le monde RWID ? » sans qu’il soit nécessaire d’ouvrir un tableau de bord technique.
Ce qu’il surveille
- Le siège de RWID à Yogyakarta — le point doré qui marque sa maison.
- Le siège d’Ecosphere et ses nœuds — là où la plateforme tourne, y compris les nœuds de production à l’étranger. Si un nœud est en vie ou en panne, cela se voit ici.
- Chaque membre — lorsque quelqu’un se connecte ou s’inscrit, une pulsation apparaît à son emplacement, avec son nom et sa ville. Ce monde bouge grâce à ses habitants.
- Un battement continu — le rythme cardiaque et les signaux d’activité qui donnent au « monde » un aspect vivant, et non celui d’une simple carte statique.
Il remplit deux rôles à la fois : la preuve sociale (les visiteurs voient que la communauté est réelle et active) et le moniteur opérationnel (d’où vient le trafic, quels nœuds sont sains). Un seul écran, deux fonctions.
Voici ce que l’on voit lors d’une attaque
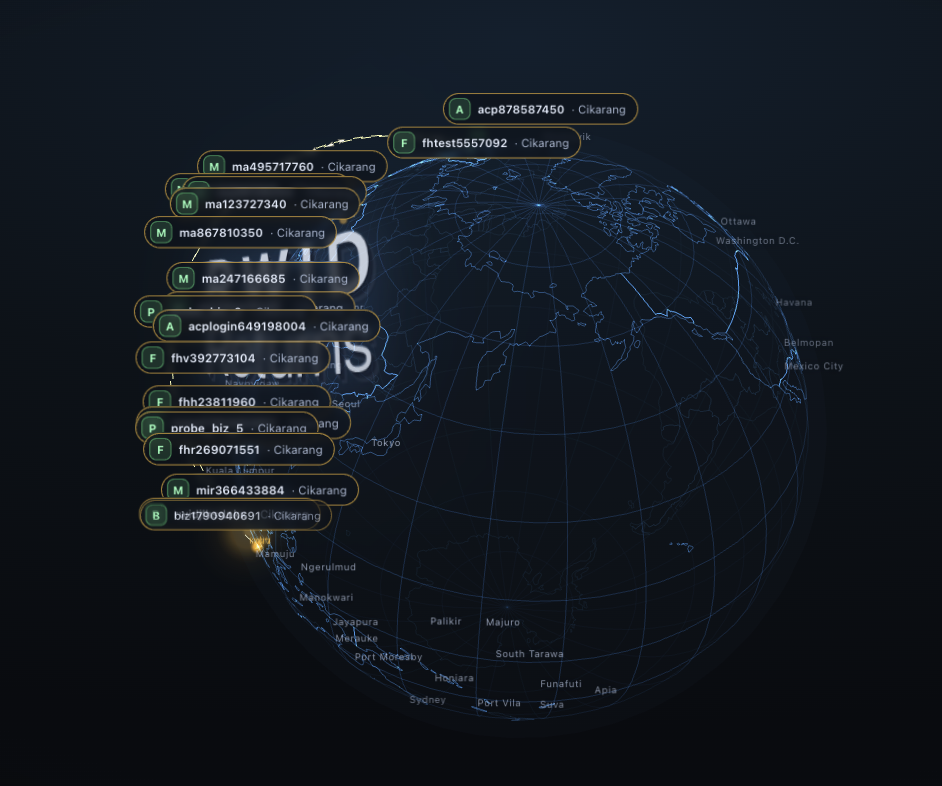
C’est une capture du globe pendant l’attaque du 2 octobre 2026. Des noms inconnus surgissent d’un seul et même point — Cikarang — à la chaîne, rapidement, de façon anormale : une suite ininterrompue depuis la même ville, selon un schéma qu’un être humain ordinaire ne pourrait pas produire. Le monde, paisible un instant plus tôt, s’est soudain agité à partir d’une unique source.
Et comme chaque pulsation s’accompagne d’un son, je n’ai pas besoin de fixer l’écran pour savoir que quelque chose cloche. L’oreille capte avant que l’œil ait le temps de lire. Dès que ce son arrive en rafale, le réflexe est unique : ouvrir le globe, et tout y est déjà clair.
Telle est la vraie valeur d’un moniteur : non pas simplement afficher des données, mais rendre ce qui est anormal visible et audible — impossible à manquer.
Le globe n’est pas le seul à crier. Sur le canal Telegram, notre bot envoie la même alerte — automatiquement, depuis le guard qui surveille la périphérie :
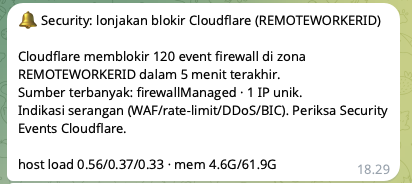
Deux signaux sont arrivés presque en même temps : l’œil (le globe) et la machine (Telegram). Ce n’est pas un hasard. Le système est précisément conçu pour avertir par plus d’une voie — afin qu’un événement qui échappe au regard soit tout de même capté ailleurs. Une bonne détection ne repose pas sur un seul sens.
Pourquoi cela compte dans un livre de sécurité
Parce que c’est justement là que l’anomalie devient visible. Lorsqu’un système est surveillé comme un seul monde vivant, ce qui est anormal saute aux yeux — un nom étrange, une pulsation déplacée. Non pas parce que quelqu’un lit les logs à trois heures du matin, mais parce que le monde lui-même montre que quelque chose ne va pas.
Un bon moniteur n’affiche pas seulement des chiffres ; il fait en sorte que ce qui est faux paraisse faux. Ce globe est l’exemple le plus évident de ce principe, et l’incident dont nous traitons à partir du chapitre 2 en est la preuve.
→ Chapitre 2 · Aperçu de l’incident.
2 · Aperçu de l’incident : une IP, dix-huit minutes
Avant d’aborder la théorie, regardons d’abord ce qui s’est réellement passé. Voici l’extrait que nous avons déjà publié comme note d’ingénierie dans la documentation d’Ecosphere, simplifié pour les lecteurs de ce livre.
Le 2 octobre 2026, entre 18:16 et 18:37 WIB environ, une adresse IP située à
Cikarang, Java occidental, a lancé un scanner de vulnérabilités automatisé
contre remoteworker.id. Sur cette période, notre périphérie (Cloudflare) a
bloqué 397 requêtes. Ce scanner visait les endpoints de connexion et
d’inscription (/signin, /signup, /api/auth/register), envoyait des probes
d’injection, et passait au crible des chemins de failles WordPress connus depuis
des dizaines d’années.
Ce qui compte, ce ne sont pas les chiffres. Ce qui compte, c’est ce qui ne s’est pas produit :
- Pas une seule donnée n’a fuité.
- Le processeur (CPU) du serveur de production est resté sous la charge normale ; l’hôte n’a presque pas sourcillé.
- Aucun compte indésirable n’a pu entrer, car la vérification par email est obligatoire.
- Notre ancien serveur n’a même jamais vu la majorité de ces requêtes, car toutes ont été rejetées à la périphérie.
La seule trace qui ait pu passer : 43 comptes indésirables inscrits depuis cette IP. Nous les avons tous supprimés ; les 30 inscrits authentiques sont restés intacts.
Première leçon : l’attaque qui vous rend plus fort n’est pas celle qui échoue, mais celle qui est détectée, contenue et signalée avec des preuves.
Cet incident n’a pas été une surprise. Il est la réponse au défi que nous avions nous-mêmes lancé. Le reste du livre explique pourquoi le système a pu rester aussi serein, et ce que vous pouvez imiter pour le vôtre.
→ Passez au Chapitre 3 · Qu’est-ce qu’Ecosphere pour comprendre les fondations qui rendent tout cela possible.
3 · Qu’est-ce qu’Ecosphere (et pourquoi LXS seul ne suffit pas)
Expliquer « LXS » sans expliquer Ecosphere, c’est comme expliquer la brique sans expliquer le bâtiment. Commençons donc par le bâtiment.
Le problème auquel on veut répondre
La manière standard de construire une application dans les années 2020 empile des couches : l’application est enveloppée dans un conteneur, le conteneur est orchestré par Kubernetes, auquel s’ajoutent un service mesh, un message broker et une kyrielle de services managés. Pour une grande équipe, c’est normal. Pour une seule personne qui construit un produit, c’est un fardeau : chaque couche augmente la surface où l’on peut se tromper et — ce qui importe davantage pour ce livre — la surface qui peut être attaquée.
Ecosphere prend une autre direction. Il considère l’application comme un ensemble de petites capacités complémentaires, et non comme un monolithe géant ni comme une multitude incalculable de conteneurs.
Les termes essentiels
- Domaine. Une responsabilité claire et autonome — identité, articles, portefeuille, notifications. Chaque domaine possède ses propres données et communique par contrat, et non en important le code des autres.
- LXS (Linux Services). La manière dont un domaine est empaqueté en un seul binaire prêt à l’emploi avec un contrat strict : les variables dont il a besoin, le port, la mémoire, et les routes qu’il expose. Détails au chapitre 5.
- Estate. L’ensemble de LXS + code central (domain core) qui forme une
application complète.
remoteworker.idest un estate. - Registry. Le catalogue de LXS versionnés. Vous réutilisez des capacités déjà éprouvées au lieu de les réécrire.
Pourquoi cela compte pour la sécurité
Une phrase : une capacité à un seul endroit signifie un seul endroit où corriger. S’il y a une faille dans le LXS d’authentification, vous corrigez une fois, publiez une nouvelle version, et tous les estates qui l’utilisent peuvent monter de version. Vous ne corrigez pas du code de connexion copié dans dix projets.
C’est ce que nous appelons la force propagée : un correctif rapide en un point se diffuse dans tout le système, au lieu de rester cantonné à une seule application.
Essayez par vous-même
Ecosphere n’est pas une théorie enfermée dans ce livre. La plateforme est ouverte à l’essai — de l’installation à la documentation, jusqu’à la composition de votre première application :
Plus il y a de personnes qui construisent dessus, plus il y en a qui contribuent à renforcer les mêmes fondations. Cela fait partie de l’intention : une sécurité partagée, et non entretenue chacun de son côté.
Dans le prochain chapitre, nous creusons ses deux racines théoriques — Domain-Driven Design et le concept de LXS lui-même — avant d’aborder le chapitre le plus important pour notre force : Gateway et Auth.
4 · Racines théoriques : Domain-Driven Design & Bounded Context
Avant LXS, il y avait d’abord l’idée : le Domain-Driven Design (DDD). Ce livre n’enseignera pas le DDD en entier, mais il y a un concept que vous devez comprendre, car c’est sur lui que repose notre sécurité.
Bounded context : un mot, un sens
Imaginez le mot « user ». Dans le domaine de l’identité, un user est un compte avec mot de passe et session. Dans le domaine des articles, un user n’est qu’un auteur. Dans le domaine du portefeuille, un user est le propriétaire d’un solde. Si vous imposez une définition unique de « user » à tout le monde, votre code devient peu à peu interdépendant, et chaque modification touche à tout.
Le bounded context est la réponse : fixer des frontières claires. Chaque contexte a son propre modèle, ses propres données et son propre contrat. Ils ne s’empruntent pas leurs types de données.
Les règles qui engagent (et pourquoi c’est une question de sécurité)
Un système bâti sur des frontières nettes possède des propriétés précieuses pour la sécurité :
- Pas d’import entre domaines. Un domaine communique avec un autre par un contrat public (généralement HTTP), et non en appelant ses fonctions internes. Cela signifie que la surface d’attaque d’un domaine est bien circonscrite : on ne peut l’appeler que par la porte déclarée.
- Stockage séparé. Chaque domaine possède sa propre base de données. Une vulnérabilité dans un domaine n’ouvre pas automatiquement toute la base. Le blast radius reste réduit.
- Références, pas copies. Un domaine conserve une référence aux données appartenant à un autre domaine (un ID), et non une copie. Aucune donnée n’est dupliquée et incohérente à plusieurs endroits.
- Identité explicite aux frontières. Une opération d’écriture ne déduit pas silencieusement le propriétaire à partir du token ; elle exige une preuve explicite.
En résumé : des limites claires sont un contrôle de sécurité. Quand un composant n’est accessible que par une unique porte déclarée, réfléchir à sa sécurité est bien plus facile qu’avec du code connecté à tout de partout.
Du concept au binaire
Le DDD explique comment penser les frontières. Il n’explique pas comment empaqueter ces frontières en quelque chose qui puisse être exécuté et composé en toute sécurité. Pour cela, il nous faut LXS — sujet du prochain chapitre.
→ Chapitre 5 · LXS : Linux Services comme briques de construction.
5 · LXS : Linux Services comme briques de construction
LXS est la manière dont un domaine est empaqueté en un seul binaire prêt à l’emploi, accompagné d’un contrat lisible aussi bien par les machines que par les humains. Il s’exécute nativement dans LXC — sans couche de virtualisation lourde, sans images de conteneurs qui s’empilent.
Ce que contient le contrat d’un LXS
Chaque LXS se déclare ouvertement :
- Les variables d’environnement dont il a besoin (et lesquelles sont des secrets).
- Le port qu’il occupe.
- Les ressources (mémoire, disque) qu’il demande.
- Les routes qu’il expose — et à quel niveau d’accès (
public,auth,role:...). - Le réseau : d’où viennent les entrées, où vont les sorties.
Ce contrat n’est pas une documentation passive. Au moment du déploiement, la plateforme vérifie que l’estate fournit bien ce qui est demandé — et rejette les compositions qui ne correspondent pas. Un LXS ne peut pas accéder discrètement à quelque chose qu’il n’a pas déclaré.
Des versions qui ne changent pas
Les LXS sont publiés en versions immuables : [email protected] désigne exactement
ce binaire. On ne modifie pas une version déjà publiée ; on corrige en publiant
une nouvelle version. Par conséquent, corriger une faille devient un acte net et
traçable : une nouvelle version, une note de changement, une décision de monter
de version dans les estates concernés.
Un domaine, un binaire
La règle « un LXS = un domaine » garde le binaire petit et ciblé. Sa surface d’attaque l’est aussi : ce processus ne transporte pas de capacités dont il n’a pas besoin. Pas de gros interpréteur, pas de framework à tout faire ; seulement le nécessaire.
Des capacités partagées, pas des copies
C’est le cœur de tout le livre : connexion, notifications, stockage, articles — ce sont les mêmes capacités dans presque toutes les applications. Nous ne les copions pas dans chaque projet ; nous les publions une fois comme LXS, puis les réutilisons. Quand un problème de sécurité surgit dans l’un d’eux, le correctif n’a pas à être répété à dix endroits.
Deux LXS déterminent le plus notre force. Ils sont traités dans le chapitre suivant.
→ Chapitre 6 · Gateway & Auth : la source de force.
6 · Gateway & Auth : la source de force qui corrige vite
Si ce livre a un chapitre que je voudrais que vous reteniez plus que les autres, c’est celui-ci.
Dans de nombreux systèmes, la sécurité est dispersée : chaque service se protège lui-même, copie la logique de connexion et a sa propre interprétation de qui peut entrer. Le résultat est prévisible : incohérent, difficile à auditer, et corriger une faille signifie toucher à de nombreux endroits.
Nous faisons l’inverse. Deux LXS détiennent presque toutes les décisions de sécurité, et tous deux sont placés devant chaque estate.
Gateway : la porte d’entrée qui refuse par défaut
Le gateway est l’unique point d’entrée d’Internet vers les services de l’estate.
Il fonctionne en deny-by-default : une route n’est franchissable que si
l’estate l’a écrite explicitement, avec son niveau d’accès (public, auth,
role:superadmin). Pas de « tout transférer ». Pas de raccourci.
Conséquences :
- Les services internes n’ont pas besoin d’être exposés directement (et ne doivent pas l’être). Seule la porte d’entrée parle au monde extérieur.
- Chaque requête est vérifiée une seule fois à un seul endroit. S’il y a une nouvelle règle ou une faille dans la logique d’accès, elle est corrigée dans le gateway et tous les estates en bénéficient.
- En tirant les leçons d’incidents comme celui du 2 octobre, nous avons ajouté des règles en un seul point — et l’ensemble de l’estate s’est trouvé protégé instantanément.
Auth : une seule autorité d’identité
Auth est le LXS qui détient l’identité : mots de passe, sessions, tokens, rôles. Il peut aussi jouer le rôle de fournisseur d’identité (OIDC), de sorte que plusieurs applications puissent partager un même compte. Comme tous les estates utilisent le même Auth, leur modèle de session est lui aussi uniforme — et c’est important, car la plupart des attaques web visent la session.
L’une des décisions les plus marquantes a été de faire passer la session de
localStorage à un cookie HttpOnly. Un cookie HttpOnly ne peut être lu par
aucun script de la page, si bien qu’une faille XSS ne signifie pas
automatiquement un vol de session. Ce changement a lui aussi été réalisé une
seule fois dans Auth, puis s’applique à tous les estates qui l’utilisent. (L’
histoire complète se trouve au chapitre 12.)
Pourquoi c’est une « force propagée »
Imaginez trois mondes :
- Le monde des copies. La connexion est copiée dans 10 applications. Une faille de session est découverte. Vous corrigez 10 endroits. Certains sont oubliés. Ceux qui sont oubliés restent fragiles pendant des mois.
- Le monde du monolithe. Un seul correctif atteint tout — mais seulement cette application. Les autres applications gardent leurs propres problèmes.
- Le monde LXS. Auth est corrigé une fois, sa version est incrémentée, et tous les estates qui le composent peuvent monter de version. Un correctif, une large portée, tracé.
C’est pourquoi j’appelle gateway et auth notre source de force. Non pas parce qu’ils sont parfaits, mais parce qu’ils nous permettent d’agir vite quand ces imperfections sont découvertes — et c’est bien plus important qu’une affirmation « sécurisé » que l’on ne peut pas prouver.
Extraits de l’incident
Quand le scanner du 2 octobre a tiré sur les routes d’entrée, ce ne sont pas tous les services qui ont tenu. C’est le gateway qui a rejeté la majorité, et Auth qui a garanti que le pare-feu d’inscription (vérification par email) reste intact. Nous n’avons pas eu à toucher vingt composants ; une porte et une autorité ont suffi.
→ Voilà pour les fondations conceptuelles. La Partie 3 commence par les principes de sécurité qui s’appliquent à n’importe quel système, LXS ou non.